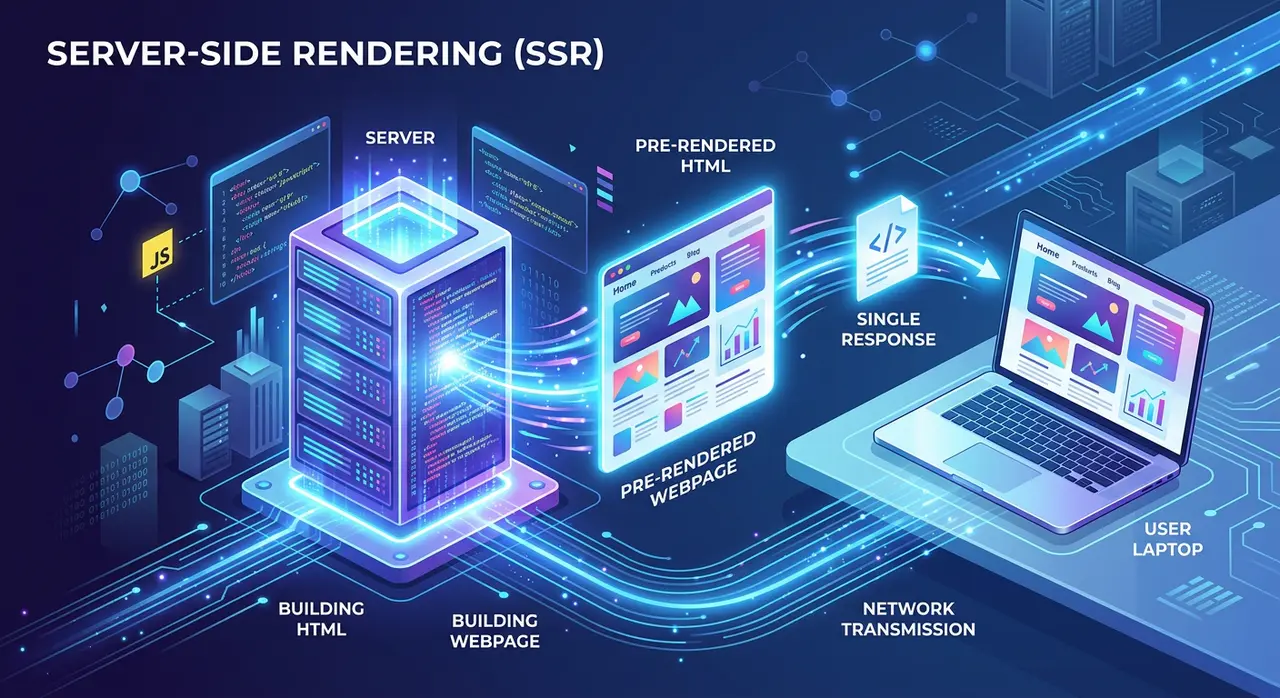
Ciao, e benvenuto nella sesta puntata della settantottesima stagione. La volta scorsa, i costi onesti, tra cui quello strano: i dati viaggiano due volte. Oggi vediamo i dati da vicino: dove si prendono, e quel raddoppio curioso. Il titolo: la ricetta sotto il piatto.
Partiamo da dove vivono i dati, che è un vantaggio vero. Per cucinare una pagina servono ingredienti, cioè i dati. Una pagina di prodotto ha bisogno del prodotto; un profilo ha bisogno dell'utente. Due posti dove prenderli: la cucina, il server, o il tavolo, il browser. Prenderli in cucina è spesso un guadagno autentico: il server sta proprio accanto alla dispensa, la base di dati, i servizi interni. Può afferrare gli ingredienti con un salto corto, veloce e privato, senza nessun viaggio avanti e indietro attraverso la rete fino a chi guarda e ritorno. Il vecchio cucinare al tavolo doveva: mostrare una pagina vuota, poi mandare una richiesta dal browser fino a un server per prendere i dati, poi aspettare, poi riempire, un viaggio avanti e indietro visibile, spesso una rotellina. Prendere in cucina ripiega la raccolta dei dati dentro il cucinare: quando il piatto arriva, gli ingredienti sono già dentro. Vicino ai dati, nessun viaggio dal tavolo.
E c'è il lato dei segreti. Siccome la presa avviene sul server, può usare segreti che il browser non deve mai vedere: la password della base di dati, la chiave privata di un servizio. La cucina può aprire la dispensa chiusa a chiave; al tavolo la chiave non si può affidare. Prendere sul server tiene i segreti sul server per costruzione.
Ma ecco il tranello che completa il tema del pagare due volte. Il server ha preso i dati e li ha cucinati dentro l'HTML, benissimo. Ma poi il client deve idratare, cioè ri-eseguire i componenti, cioè ai componenti servono di nuovo gli stessi dati. Se il client li riprendesse da zero, pagheresti il viaggio avanti e indietro che avevi appena evitato, e per di più il client potrebbe ottenere dati diversi da quelli che ha usato il server, causando una mancata combaciata. Allora, invece, lo strumento infila i dati sotto il piatto: prende i dati che il server ha usato e li spedisce accanto all'HTML, così il client può idratare esattamente con gli stessi ingredienti, senza riprenderli. Il cartoncino della ricetta viene fatto scivolare sotto il piatto. Funziona, ma vuol dire che i dati sono sul filo due volte: una cotti dentro l'HTML visibile, e una di nuovo come dati crudi per l'idratazione. La tua pagina è più pesante perché porta sia il piatto cotto sia la sua ricetta.
Ti chiederai: perché spedire i dati due volte, il client non può rileggerseli dall'HTML? A volte un po', ma non in modo affidabile: l'HTML è il piatto cotto, che perde traccia degli ingredienti originali, non sempre puoi ricostruire i dati crudi dal risultato impiattato. I dati messi da parte sono la ricetta fedele. L'HTML è per i tuoi occhi, il primo sguardo veloce; il pacchetto di dati è per la logica del client, l'idratazione corretta. Due forme della stessa cosa, per due consumatori diversi. È ridondante sul filo, ma ogni copia serve a uno scopo che l'altra non può coprire.
Nel pratico, è per questo che prendi sul server e passi i dati giù è il modello dei dati del rendering lato server, e perché gli strumenti ti danno posti apposta dove prendere i dati: così vengono raccolti una volta, sul server, cotti dentro l'HTML, e messi in automatico sotto il piatto per l'idratazione. Gli errori sono le immagini speculari: riprendere sul client ciò che il server aveva già, pagando il viaggio due volte, oppure mettere sotto il piatto molti più dati di quanti alla pagina servano, una ricetta gonfia. Prendi una volta, e spedisci solo ciò che all'idratazione serve davvero.
Voglio lasciarti con il modello dei dati nel rendering lato server. I dati vanno presi dove sono vicini, nella cucina, accanto alla dispensa, non al tavolo dopo un viaggio avanti e indietro. Ma ricorda che quei dati faranno il filo due volte: una cotti dentro l'HTML che vedi, una crudi sotto il piatto, perché il client possa idratare con gli stessi ingredienti senza rifare il viaggio. Non è spreco inutile: sono due forme per due consumatori, i tuoi occhi e la logica del client. La disciplina è una sola: prendi i dati una volta, sul server, e metti sotto il piatto solo quello che l'idratazione serve davvero. Ogni ingrediente in più sotto il piatto è peso che chi guarda scarica senza vederlo.
Per oggi ci fermiamo qui. Abbiamo visto dove prendere i dati, cioè in cucina, vicino alla dispensa e dietro la porta dei segreti; il raddoppio della ricetta sotto il piatto, i dati sul filo due volte, cotti e crudi; perché servono entrambe le forme, per occhi e per logica; e la disciplina di prenderli una volta e spedire solo il necessario. Nella prossima puntata: portate che escono quando sono pronte. Nelle note trovi qualche spunto. Se ti è utile, condividila. Grazie per l'ascolto, e ci sentiamo alla prossima.