Ciao, e benvenuto nella nona puntata della diciannovesima stagione. Finora abbiamo parlato di una base di dati come di un'unica macchina che custodisce tutto. Ma cosa succede quando i dati e gli utenti diventano così tanti che una sola macchina non basta più? E cosa succede quando il rigido modello a tabelle non è la forma migliore per i tuoi dati? Oggi affrontiamo due temi che allargano l'orizzonte: come una base di dati cresce oltre una macchina sola, e quali altri modelli esistono oltre a quello a tabelle. Perché non esiste un'unica soluzione buona per tutto.
Partiamo dal problema della crescita, che riprende un tema della stagione su Kubernetes. All'inizio, la tua base di dati sta comodamente su una sola macchina. Ma se il tuo servizio ha successo, i dati crescono, gli utenti si moltiplicano, e arriva il giorno in cui quella macchina non ce la fa più: è troppo lenta, troppo carica, troppo piena. Come si affronta questa crescita? Ci sono due strade principali, molto diverse tra loro, ed entrambe hanno pregi e difetti. Capirle aiuta a capire come i servizi grandi reggono quantità enormi di dati e di traffico.
La prima strada è la più semplice: rendere la macchina più potente. Le dai più memoria, un processore più veloce, dischi migliori. È l'approccio di comprare una macchina più grande, e ha il vantaggio di essere semplice: non cambi come funzionano le cose, potenzi solo l'hardware. Ma ha un limite netto: per quanto potente, una singola macchina ha un tetto, oltre il quale non puoi andare, e avvicinandosi a quel tetto costa sempre di più. Ingrandire una macchina sola ti porta lontano, ma non all'infinito: prima o poi sbatti contro un muro fisico ed economico.
La seconda strada, più potente ma più complessa, è distribuire i dati su tante macchine, invece di una sola gigante. Invece di una macchina enorme, tante macchine normali che si dividono il lavoro e i dati, collaborando. Questo approccio, in teoria, non ha il tetto dell'altro: se serve più capacità, aggiungi altre macchine. Ma introduce una complessità notevole, la stessa dei sistemi distribuiti che abbiamo incontrato: come dividere i dati tra le macchine, come tenerli coordinati e coerenti quando sono sparsi, cosa succede se una macchina si guasta. Distribuire dà una capacità quasi illimitata, ma al prezzo di problemi difficili da gestire.
Voglio evidenziare un compromesso profondo che emerge quando distribuisci i dati, perché è una delle tensioni fondamentali di questo campo. Quando i dati vivono su tante macchine, mantenerli perfettamente coerenti, cioè far sì che tutti vedano sempre lo stesso identico valore aggiornato all'istante, diventa molto difficile, e a volte è in conflitto con l'essere sempre disponibili e veloci. Spesso bisogna scegliere: privilegiare la coerenza assoluta, accettando qualche lentezza o indisponibilità, oppure privilegiare la disponibilità e la velocità, accettando che a volte i dati possano essere leggermente disallineati per un istante. Non puoi sempre avere tutto al massimo insieme: distribuire impone dei compromessi, e scegliere bene dipende da cosa conta di più per te.
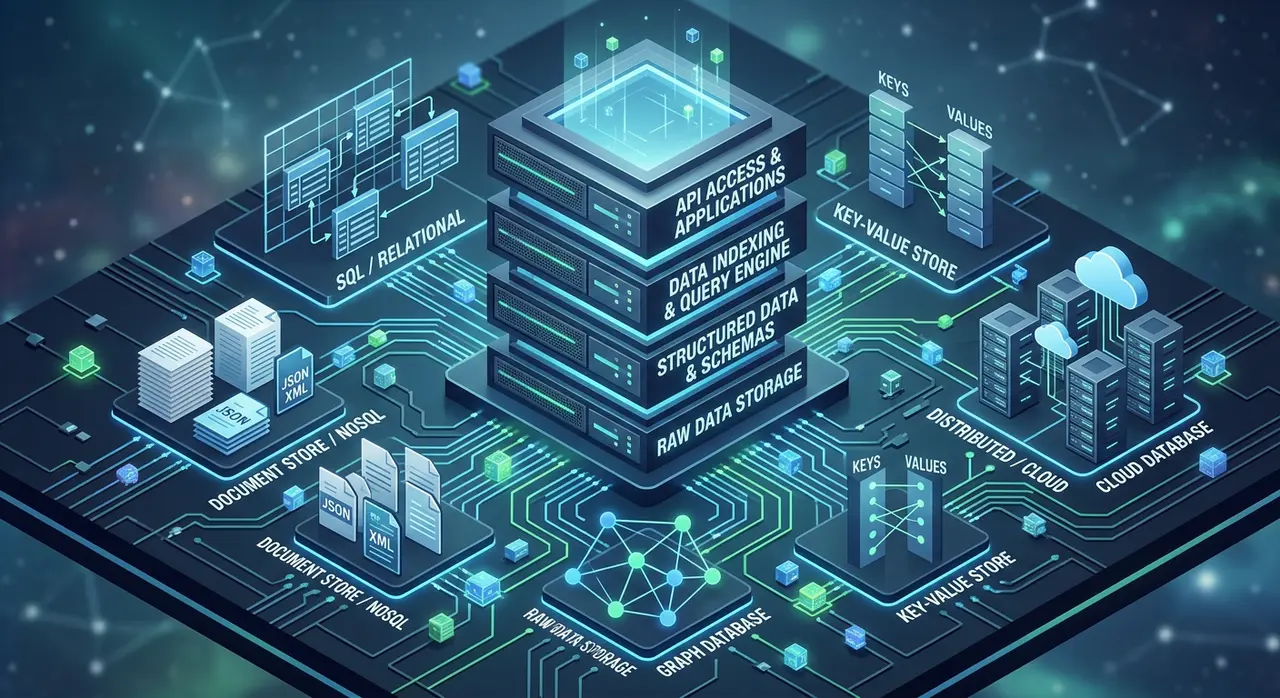
Passiamo ora al secondo tema della puntata: oltre al modello a tabelle, esistono altri modelli di basi di dati. Per decenni abbiamo detto tabelle, righe e colonne, schema rigido, ed è tuttora il modello dominante e ottimo per moltissimi usi. Ma ci si è resi conto che non tutti i dati hanno la forma di una tabella ordinata, e per certe esigenze sono nati modelli diversi. Ci sono basi di dati pensate per conservare documenti dalla forma libera e variabile, invece di righe rigide e uniformi. Altre pensate per associazioni semplicissime e velocissime tra un'etichetta e un valore. Altre ancora pensate per rappresentare reti di connessioni, come le relazioni tra persone in un social. Ogni modello è tagliato su misura per una certa forma di dati e un certo modo di usarli.
Voglio trarre da questo una lezione che riprende lo spirito onesto del podcast: si sceglie lo strumento in base ai dati, non c'è un vincitore assoluto. Il modello a tabelle non è né superato né sempre la scelta migliore: è eccellente per dati strutturati e relazioni, dove la coerenza e le garanzie contano, e resta la scelta giusta per la stragrande maggioranza delle applicazioni. Gli altri modelli brillano in situazioni specifiche, dove la forma dei dati o le esigenze di scala lo richiedono. La saggezza non sta nel cercare il modello migliore in assoluto, che non esiste, ma nello scegliere quello giusto per i tuoi dati e i tuoi bisogni. Come sempre, lo strumento va scelto per il problema, non per moda.
Per oggi ci fermiamo qui. Quando una macchina sola non basta più, si può crescere in due modi: rendere la macchina più potente, semplice ma con un tetto, oppure distribuire i dati su tante macchine, potente ma complesso, con il compromesso profondo tra coerenza e disponibilità. E oltre al modello a tabelle, che resta dominante e ottimo per dati strutturati e relazioni, esistono altri modelli, per documenti liberi, associazioni veloci, reti di connessioni, ciascuno tagliato su una forma di dati. La lezione è che si sceglie lo strumento in base ai dati e ai bisogni: non esiste un vincitore assoluto. Nella prossima e ultima puntata tiriamo le somme e guardiamo lontano. Nelle note trovi qualche spunto. Se ti è utile, condividila. Grazie per l'ascolto, e ci sentiamo alla prossima.